整改中 / Under revision
本项目正在整改,本页当前的介绍与性能数据不可靠,请勿直接引用。页面中的数据采集自一台已下线的腾讯云 VM,目前无法复现。benchmark 测量方法正在审计中,已确认存在多处测量问题,包括:未区分排队延迟与服务延迟、部分微基准存在跨迭代状态污染、计时区间边界错误。详见
docs/AUDIT.md。修正后的裸机(bare-metal)重测正在进行中,完成后将更新本页。This project is under revision; the description and figures on this page should not be relied on. The data was collected on a now-decommissioned Tencent Cloud VM and is no longer reproducible. The benchmark methodology is currently under audit, and several measurement issues have been confirmed, including failure to separate queueing delay from service latency, cross-iteration state contamination in some microbenchmarks, and incorrect timing-region boundaries. See
docs/AUDIT.mdfor details. A corrected bare-metal re-benchmark is currently in progress.
低延迟撮合引擎(C++20)
本项目为用 C++20 从零实现的交易所撮合引擎核心组件,聚焦于无锁流水线设计与热路径零堆分配,以数据驱动的方式逐步将吞吐量提升至 Mutex 基线的 2.65×,P99 延迟改善 5.1×。
核心特性
- 无锁 SPSC 双队列流水线:以自实现的
SPSCRingBuffer替代std::mutex+condition_variable,生产者/消费者完全在用户态通信,彻底消除futex系统调用开销。 - 热路径零堆分配:
OrderMemoryPool(free-list + placement new)提供 O(1) 分配/回收;TradeRingBuffer<4096>预分配 Trade 缓冲,两者合力消除高频路径上的malloc尾刺。 - perf 驱动的数据结构优化:通过
perf record+ FlameGraph 定位std::unordered_map为 ~32% CPU 热点,迁移至absl::flat_hash_map(Swiss Table),热点降至 ~12%。 - Cache Line 纪律:
Order结构alignas(64),sizeof == 64(static_assert强制),整体恰好一条 cache line;SPSChead_/tail_各自对齐,消除生产者/消费者间 false sharing。 - 并发正确性验证:33 个 GTest 单元测试,全程开启 AddressSanitizer + ThreadSanitizer,覆盖完全成交、部分成交、撤单与并发场景。
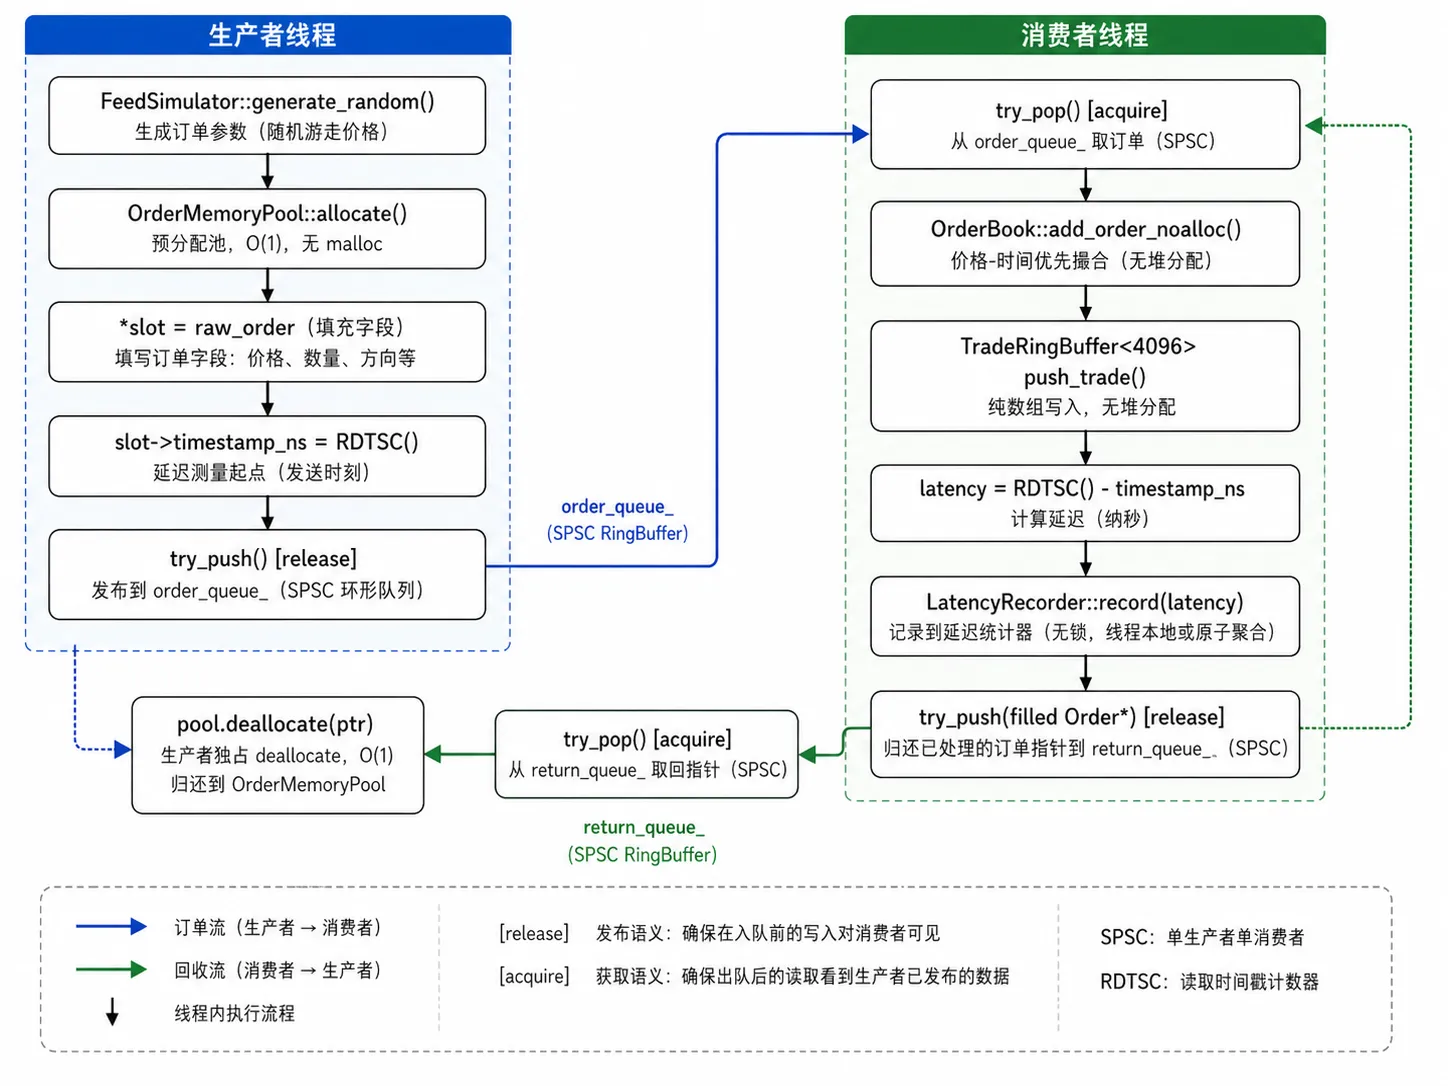
架构图
多线程撮合引擎完整流程架构请参考以下或顶部大图。
生产者线程                                    消费者线程
─────────────────────────                  ──────────────────────────
FeedSimulator::generate_random()
  │ 生成订单(随机游走价格)
  ▼
OrderMemoryPool::allocate()                ┌── try_pop() [acquire] ◄──────┐
  │ O(1),无 malloc                         │                              │
  ▼                                         ▼                              │
*slot = raw_order(填充字段)          OrderBook::add_order_noalloc()       │
  │                                         │ 价格-时间优先撮合             │
  ▼                                         ▼                              │
slot->timestamp_ns = RDTSC()          TradeRingBuffer<4096>                │
  │ 延迟测量起点                             │ 纯数组写,无堆分配            │
  ▼  [order_queue_]                         ▼                              │
try_push() [release] ──────────►    latency = RDTSC() - timestamp_ns       │
                                            │ → LatencyRecorder            │
                                            ▼  [return_queue_]             │
pool.deallocate(ptr) ◄── try_pop() ◄── try_push(Order*)  ─────────────────┘
  生产者独占 deallocate,无需任何 mutex
两条 SPSC 队列的 release/acquire 内存序是唯一的同步手段,无任何额外锁或系统调用。
性能结果
测试环境:腾讯云 VM,2 vCPU @ 2.494 GHz,Release(-O2),
taskset -c 0,1,100K orders
流水线对比(Mutex vs SPSC,100K 订单)
| 指标 | Mutex 基线 | SPSC 优化版 | 改善 |
|---|---|---|---|
| 吞吐量 | 1.19 M orders/s | 3.15 M orders/s | 2.65× |
| P50 延迟 | ~4.77 ms | ~1.26 ms | 3.8× |
| P99 延迟 | ~12.59 ms | ~2.49 ms | 5.1× |
OrderBook 数据结构优化(单线程微基准)
| Benchmark | v1 基线 | v3 优化 | 改善 |
|---|---|---|---|
| BM_AddOrder_NoMatch | 83.5 ns | 46.4 ns | +44% |
| BM_CancelOrder | 60,456 ns | 26,659 ns | +56% |
| BM_MixedWorkload 吞吐 | 3.87 M ops/s | 6.19 M ops/s | +60% |
| add_order_noalloc(零堆分配) | 6.19 M ops/s | 8.04 M ops/s | +30% |
源码及完整 benchmark 结果请见 GitHub →